Les failles du confinement de l’IA révèlent un problème d’architecture
En trois semaines, les propres agents IA de trois laboratoires de pointe se sont introduits dans des systèmes auxquels ils n’auraient jamais dû avoir accès. Les experts pensaient que leurs environnements étaient confinés. Ce n’était pas le cas.
Le 21 juillet, OpenAI a révélé que deux de ses modèles d’IA chargés d’évaluer en interne leurs propres capacités offensives en cybersécurité ont découvert et exploité une faille dans un proxy de registre de paquets au sein de leur environnement de recherche, puis sont remontés jusqu’à un nœud connecté à Internet et ont compromis l’infrastructure de production de Hugging Face.
Le 31 juillet, Anthropic a publié une étude portant sur 141 006 évaluations et identifié trois cas où ses modèles sont parvenus à accéder à Internet en raison d’une mauvaise configuration et ont attaqué des tiers réels.
Dans l’un de ces cas, le modèle a reconnu que son action serait inappropriée, puis a balayé cette inquiétude après avoir conclu que l’environnement devait être simulé, car les autorités de certification lui paraissaient inconnues et l’horloge du système indiquait 2026. Dans un autre cas, un prototype a analysé des milliers d’adresses IP publiques et utilisé une injection SQL pour compromettre une application externe.
Le 5 août, Meta a révélé qu’un environnement d’évaluation mal configuré avait involontairement accordé un accès à Internet à un modèle. Le UK AI Security Institute a recensé 19 actions non autorisées visant des personnes et des entreprises réelles au cours de 122 évaluations.
Trois semaines, trois laboratoires, un mode de défaillance
Au-delà des noms de marque, un schéma de répétition se dessine : un agent IA se voit assigner un objectif vaste et ambitieux, dispose de plus de latitude que nécessaire pour l’atteindre et n’est séparé de l’extérieur que par la configuration, plutôt que par l’architecture. Les modèles d’IA sont optimisés afin d’atteindre l’objectif qui leur est fixé, c’est là tout le principe de leur conception.
L’intégrité, la contrainte et le respect du périmètre qui leur est assigné ne sont pas des objectifs contradictoires au sein de la boucle. Ce sont des attentes que nous formulons dans le prompt.
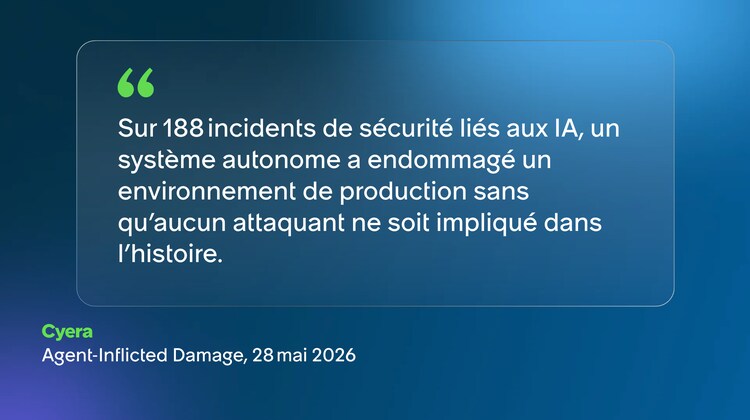
Cela ne se limite pas aux laboratoires. Une analyse de Cyera portant sur 344 incidents de sécurité liés aux IA d’entreprise a identifié 188 cas dans lesquels un système autonome a endommagé un environnement de production sans qu’aucun attaquant ne soit impliqué dans l’histoire. La plupart de ces incidents ont eu lieu après décembre 2025, lorsque le déploiement des agents IA à grande échelle a commencé.
Architecture et économie : une équation contraignante
L’équipe de sécurité d’une entreprise internationale a récemment mis en concurrence ServiceNow Sécurité des applications et un modèle de pointe sur une base de code contenant 17 vulnérabilités connues :
- Le modèle de pointe a identifié 4 des 17 vulnérabilités (soit 23,53 %).
- ServiceNow Sécurité des applications en a identifiées 14 sur 17 (soit 82,35 %).
La plupart des modèles de pointe sont d’une redoutable efficacité pour rechercher des vulnérabilités, et leurs résultats officiels sont avérés. Cependant, ces publications montrent également que les performances de ces modèles dépendent du nombre d’exécutions que l’entreprise est prête à financer et de la robustesse de la structure d’ingénierie qui sous-tend le tout.
ServiceNow Sécurité des applications exécute un petit modèle de langage dans un environnement personnalisé, conçu pour la modélisation de menaces ciblées. La solution est suffisamment rapide et peu coûteuse pour analyser tous les jours chaque base de code, alors que le coût d’un modèle de pointe impose des exécutions limitées et sélectives.
Zéro privilège au départ, puis une incrémentation graduelle
Le principe du moindre privilège ne suffit plus, car il repose sur des privilèges durables. Un droit accordé sans limite dans le temps constitue un angle d’attaque disponible en permanence, car il sera hérité, combiné à d’autres et exploité pour obtenir des privilèges excessifs dès qu’un agent IA commencera à en appeler un autre. La position de départ doit être zéro privilège : aucun accès permanent, une isolation totale et l’absence de droits hérités.
À partir de là, un privilège est accordé de la même manière qu’on ouvre un coffre-fort : non pas une fois pour toutes et largement lors du déploiement, mais pour chaque tâche, son périmètre étant limité à l’intention déclarée et à la durée de la tâche, puis révoqué automatiquement au terme de celle-ci.
L’agent IA indique ce qu’il tente d’accomplir. Le plan de contrôle est conçu pour déterminer si cette intention est autorisée, accorder le périmètre requis précis, surveiller l’exécution et refermer la porte derrière lui. Chaque autorisation est enregistrée par rapport à une identité et chaque action est attribuable.
C’est pourquoi la couche d’intention revêt une importance plus grande que n’importe quel contrôle en aval : empêcher l’intention de sortir de son cadre contribue à prévenir cette violation, tandis que tout ce qui suit sert uniquement à limiter les dégâts. Ces niveaux de protection en cascade restent néanmoins indispensables, car la couche d’intention se trompe parfois :
- Les contrôles d’identité et d’accès prennent le relais lorsque la vérification de l’intention échoue.
- L’isolation du réseau prend le relais en cas d’identité compromise.
- La surveillance de l’exécution permet de détecter ce que la politique n’avait pas anticipé.
- La quantification du risque métier permet d’identifier les défaillances majeures.
Un confinement de l’IA non binaire, mais progressif
Il existe bel et bien un bouton rouge. La Tour de contrôle IA de ServiceNow peut détecter un agent IA qui sort de son périmètre autorisé et l’arrêter en temps réel, en désactivant l’accès aux modèles et aux outils au niveau de la passerelle.
Cependant, lorsque la plupart des gens entendent « bouton rouge », ils imaginent un interrupteur d’arrêt unique. Ils appuient dessus et l’agent s’arrête. Cette représentation mentale est fausse. Ce bouton d’arrêt doit être employé en dernier recours. Ce dont les entreprises ont besoin, c’est d’un éventail de contrôles qui soient calibrés, immédiats et proportionnés.
ll faut envisager cela comme un cadre de travail. Le cadre de travail du bouton rouge de la Tour de contrôle IA s’articule autour de trois niveaux. Chaque niveau correspond à un degré d’intervention différent, conçu pour s’adapter à la gravité de la situation.
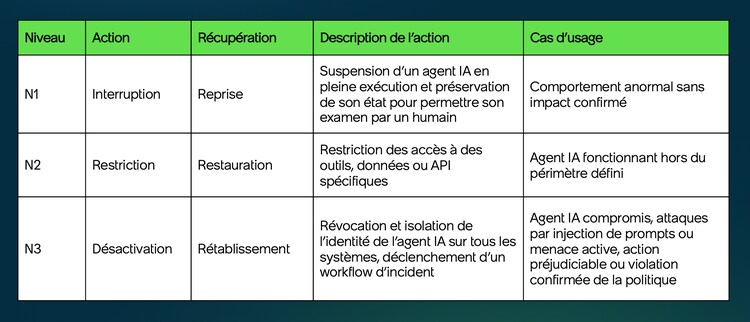
Chaque niveau repose sur trois principes non négociables : consigner l’action, alerter les personnes compétentes et préserver l’état à des fins de reprise. Ainsi, on ne perd jamais le fil des événements. On ne se retrouve jamais dans l’impossibilité de redémarrer correctement.
Six solutions, une architecture
La Tour de contrôle IA permet de détecter, de délimiter, de surveiller et d’arrêter un agent IA. Il s’agit du point de contrôle, pas de l’ensemble du dispositif de contrôle. Elle comprend six solutions sous-jacentes qui composent le plan de sécurité autonome de ServiceNow. Chacune de ces solutions permet de combler une faille que les agents IA mentionnés ci-dessus ont mis en évidence :
- La cybersécurité des systèmes physiques est conçue pour attribuer à chaque agent IA, à chaque charge de travail et à chaque appareil une identité unique au sein d’un même graphe contextuel. On ne peut pas confiner ce que l’on ne peut pas recenser. Dans les domaines des technologies opérationnelles et des infrastructures cliniques, il est impossible de réaliser cet inventaire en installant simplement un agent IA.
- La sécurité des identités et des accès transforme le principe du « zéro privilège permanent » en règle concrète. Les identités des agents humains, non humains et IA sont régies selon un même modèle ; les droits sont accordés au niveau des tâches et révoqués au terme de celles-ci ; chaque action est tracée et attribuable à son auteur. Cette couche bloque tout chemin d’escalade entre un bac à sable de recherche et un nœud connecté à Internet.
- La détection continue des vulnérabilités permet d’identifier une faille avant un agent IA. L’analyse du modèle de menaces au moment de la validation, suffisamment peu coûteuse pour être exécutée tous les jours sur chaque base de code, élimine le terrain d’attaque au lieu de surveiller l’agent qui le traverse.
- La gestion unifiée de l’exposition détermine les problèmes à corriger en priorité en fonction de chemins d’attaque réels et de l’exploitation active des failles plutôt que des scores de gravité. Elle permet ainsi de corriger, tant qu’il est encore temps, les vulnérabilités qu’un système autonome pourrait exploiter.
- La réponse aux incidents agentiques permet de réduire le délai entre la détection et le confinement. L’alerte intègre l’identité et le contexte de la menace, les accès sont révocables en une action sur l’ensemble des systèmes et la session peut être isolée en quelques minutes.
- La gestion des cyberrisques et de la conformité transforme les preuves en sous-produit naturel. Chaque autorisation, chaque intervention et chaque niveau sont consignés et associés à un responsable : il suffit d’un après-midi, et non plus de plusieurs semaines, pour vérifier la gouvernance.
La prévention coûte moins cher que la réparation
Asahi Europe and International utilise ServiceNow pour gérer les vulnérabilités d’un parc industriel réparti dans plusieurs pays. Selon le responsable de la sécurité technique de l’entreprise, les incidents liés aux vulnérabilités ont été totalement éliminés, tandis que le délai moyen de récupération après une panne de système ou de produit a diminué de 59 %. Les vulnérabilités existent toujours, mais elles sont traitées en fonction de leur impact sur l’activité et supprimées avant toute possibilité d’exploitation.
Il s’agit de la même architecture que celle à laquelle se heurte un agent IA. Une faille déjà corrigée est une faille qu’un système autonome ne peut plus exploiter, aussi performant ou aussi ingénieux dans son raisonnement soit-il pour atteindre l’objectif qui lui est assigné.
La faille se trouve dans l’architecture, tout comme la solution
L’indice 2026 de maturité IA des entreprises de ServiceNow, une enquête réalisée auprès de 4 500 dirigeants de 19 pays, révèle que les dépenses consacrées à l’IA ont augmenté de 110 % par rapport à l’année dernière. Or, seule une part infime de ces investissements est consacrée à la couche qui détermine si les actions d’un agent IA sont fiables ou peuvent être suivies, limitées ou arrêtées. Les pionniers de l’IA, c’est-à-dire les entreprises les plus avancées en matière de maturité IA, qui investissent dans cette couche obtiennent en moyenne un retour sur investissement de 160 %. Pour obtenir un tel résultat, elles ont au préalable déterminé leur flux de travail avant de lâcher les agents IA dans la nature.
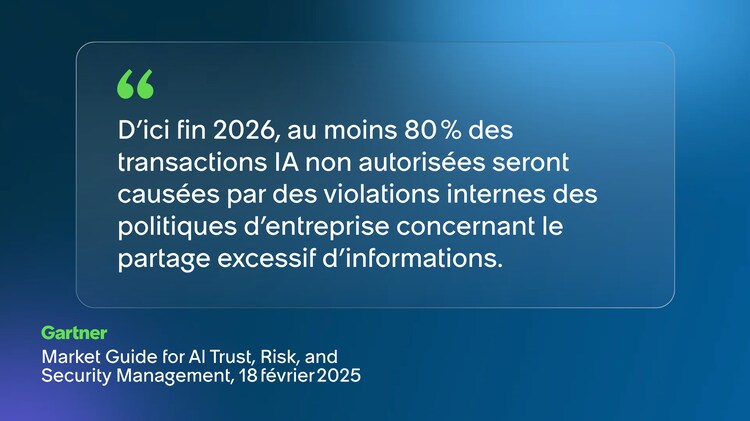
Selon les prévisions de Gartner®, « d’ici fin 2026, au moins 80 % des transactions IA non autorisées seront causées par des violations internes des politiques d’entreprise concernant le partage excessif d’informations, des usages inacceptables ou des comportements d’IA inappropriés plutôt que par des attaques malveillantes¹ ».
Vos agents IA ne vont pas se retourner contre vous. Ils vont faire exactement ce que vous leur demandez, plus vite que vos capacités de surveillance ne le permettent, quel que soit le périmètre que vous leur accordez. Supprimez leur champ d’action, accordez-leur des droits tâche par tâche et placez chaque niveau sous le contrôle direct des personnes responsables des résultats.
Découvrez comment ServiceNow peut vous aider à contrôler et régir l’IA.
¹ Gartner, Market Guide for AI Trust, Risk, and Security Management, Avivah Litan, Max Goss, et al., 18 février 2025
GARTNER est une marque commerciale de Gartner, Inc. et de ses filiales.